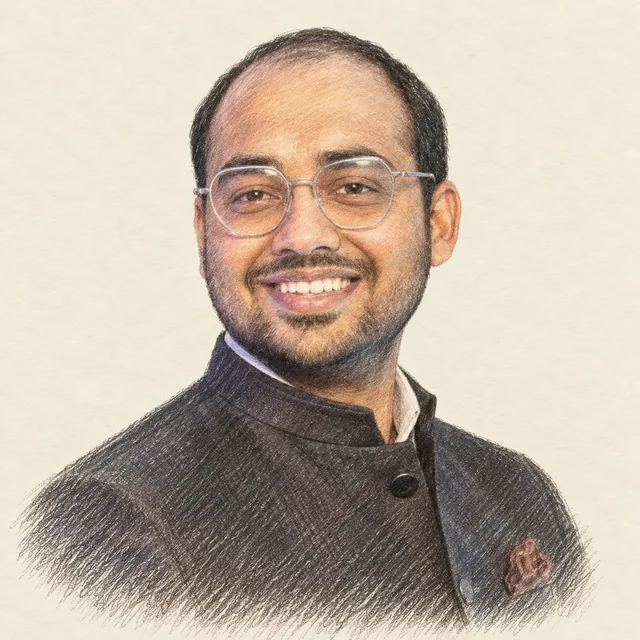
核心内容
Lakshya Agrawal 讨论 GEPA 与基于反思的优化,关注这种方法与强化学习的比较。
介绍依据 · 发布标题 · 完整内容待核读
编辑导览,依据原始来源 ↗,整理于 2026-10-06。 介绍只说明标题中的讨论议题,不据此判断讲者结论。
针对复杂智能体工作流,传统的强化学习因仅回传标量奖励(0/1)而丢失了执行轨迹与错误诊断等高密度反馈;通过在文本空间进行反思优化与进化搜索,模型能够用极少样本大幅超越强化学习微调,且任何可表达为文本并被评估的系统(代码、提示词、Agent 框架)均可通过该范式持续自进化。
原话
2逐字核对过;核对了说话人和位置有人曾问我,随着底层模型能力不断变强,提示词优化的重要性是否会下降?我的观点恰恰相反:模型越强,其指令遵循能力就越敏锐;当你给一个极其聪明的模型提供关于具体任务愈发精确、高质量的指令时,它在解决该任务上的表现就会呈指数级跃升。
people have asked me that oh as models get better the importance of prompt optimization will go down. I argue the opposite which is as models get better they will get better at instruction following and the more precise instruction about your task that you have to give to a very smart model the better that model will be at a uh solving your task
语境:Lakshya Agrawal 驳斥「模型越强提示工程越无用」的流行论调:更聪明的模型具备更精细的上下文理解力,任务指令与引导信息的精确度反而成为拉开性能差距的乘数。
我们的核心思路是在文本空间中执行反思式优化:不再仅仅依赖 0 或 1 这种粗粒度的标量奖励信号,而是让大语言模型或智能体审视整个执行轨迹,并深入反思其中哪些步骤有效、哪些无效。
Our idea is to perform reflective optimization in text space where instead of only using the zero or one reward signal, we can have a language model or an agent look at the trace of the entire rollout and reflect on what worked in them, what did not work in them.
语境:Lakshya Agrawal 阐释 GEPA 与传统 RL 的本质区别:传统梯度回传抛弃了中间工具调用与报错诊断,而文本反思能直接提取高阶语义诊断信息实现跳跃式改进。
主张
1转述不加引号;附原文依据和位置,核对范围见语境与收据优化对象的本质是文本表征与可量化反馈;只要任何系统的配置、提示词或代码框架能被序列化为文本并获得评估打分,反思式进化算法就能通用地对其实现自动化收敛与持续优化。
语境:Lakshya Agrawal 提出通用优化协议 Optimize Anything:将 Prompt 优化扩展至 CUDA 核函数、Agent 脚手架与数值参数等任意可文本化构件的自进化。
相关
 重写智能体能不能掰弯智能曲线:RSI 的四级演进
Zhengyao Jiang·Machine Learning Street Talk·播客 · 2026-09-26
同话题 · 递归自我改进已核对原话
 OpenAI 研究员谈智能体集群与递归自我改进
Noam Brown·Dwarkesh Podcast·播客 · 2026-09-17
同话题 · 递归自我改进已核对原话
 自动研究让我们的模型快了 3 倍:GPU 算子搜索与防作弊
Tejas Bhakta·AI Engineer·演讲 · 2026-09-26
同话题 · 递归自我改进已核对原话
 一个会自我改进的智能体是怎么造的
Zubin Aysola·AI Engineer·演讲 · 2026-09-26
同话题 · 递归自我改进已核对原话
 Alan Chan:智能体实时监控、身份与失控应对
Alan Chan·Cognitive Revolution·播客 · 2026-10-14
同话题 · 递归自我改进
 David Silver 与 Lasse Espeholt:从经验中自主学习的超级学习者
David Silver · Lasse Espeholt·Sequoia Training Data·播客 · 2026-10-13
同话题 · 递归自我改进